

AI搜索的流量分配逻辑,与传统SEO存在本质区别:传统搜索给的是十条蓝色链接,AI搜索给的是“一段由模型写出来的答案”,而这段答案里只会引用少数几个来源。结论先行——能否被AI搜索抓取并引用,取决于你是否同时满足三个条件:可被抓取的技术通路、可被召回的内容切片、可被信任的引用信号。缺任何一环,你的内容都不会出现在AI答案里。本文按“抓取→索引→召回→重排→生成引用”的完整链路逐段拆解,并给出可落地的GEO优化动作。
一、抓取层:AI爬虫与搜索引擎爬虫的差异
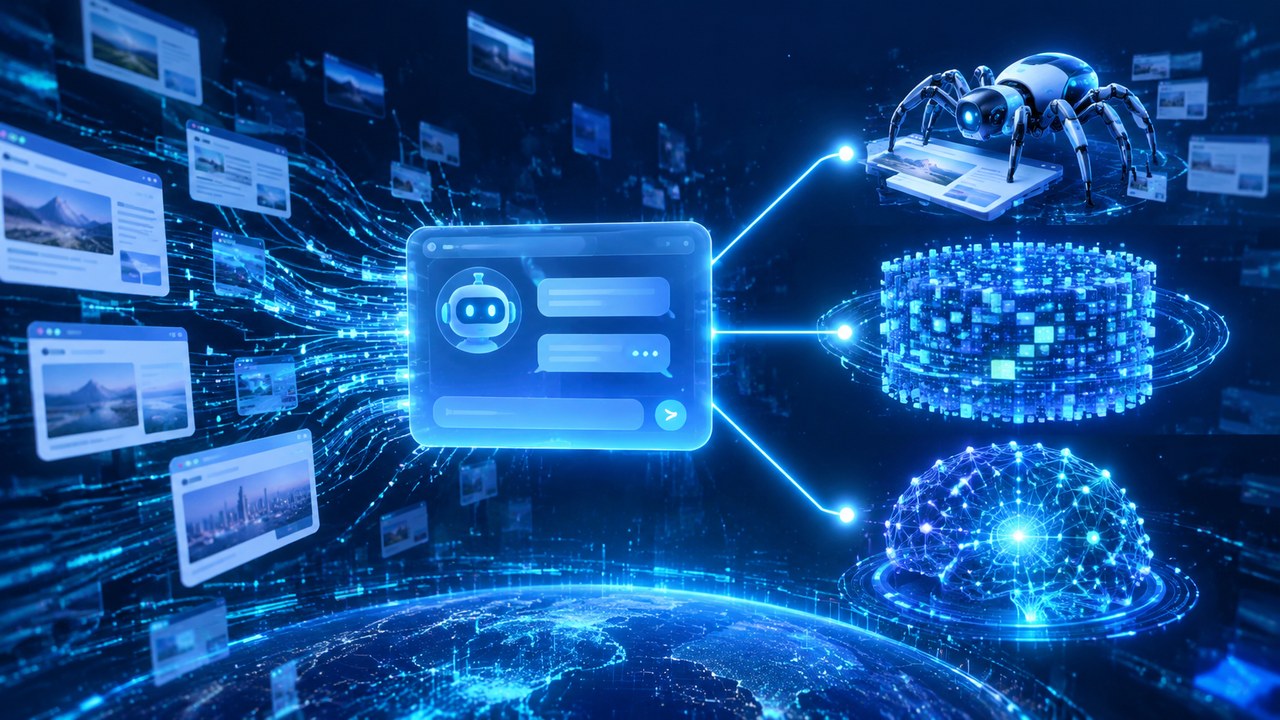
AI搜索的内容来源主要有两条通路。第一条是自建爬虫,例如OpenAI的GPTBot、OAI-SearchBot,Anthropic的ClaudeBot,Perplexity的PerplexityBot,以及Google用于AI Overviews的Google-Extended。第二条是调用第三方搜索API或索引,例如Bing、Google、Brave的搜索结果,再由模型做二次加工。这两条通路的共同点是:都依赖robots.txt的许可与页面的可渲染性。2024年以来,大量媒体站点在robots.txt中屏蔽GPTBot,结果是在ChatGPT的联网回答中彻底消失,这就是最直接的抓取层教训。对企业站而言,第一步是检查服务器日志中的User-Agent,确认GPTBot、PerplexityBot、ClaudeBot、Bytespider是否被放行,同时确认CDN与WAF没有把AI爬虫误判为恶意流量拦截。第二步是保证页面服务端渲染或预渲染,因为多数AI爬虫不执行完整JavaScript,纯前端渲染的SPA页面在抓取层就已经出局。
二、索引层:内容如何被切片与向量化
抓取之后,AI搜索引擎不会保存整篇文章,而是把内容切成若干语义片段,通常按段落或按500到1000个token的窗口切分,再通过嵌入模型转成向量存入向量数据库。这意味着一个关键事实:你的文章是作为一个整体的“片段集合”被检索的,而不是作为一个整页被检索。因此,段落的自包含性极其重要。如果一段话里大量使用“它”“这个方案”“上述方法”这类指代,切片之后语义就会残缺,向量匹配分数下降。GEO写作的一条硬规则是:每个段落尽量独立成义,标题与段落之间保持强关联,让任何一个段落被单独抽出来时仍然能读懂、能回答一个具体问题。这也是结构化写作在AI搜索时代比传统SEO时代更重要的原因。
三、召回层:什么内容会被选中进入候选集
当用户在AI搜索里提问,系统会先把问题向量化,然后在向量库中做相似度检索,取回Top-K片段,常见K值在20到100之间。这一层的竞争维度是语义相关性,而不是关键词密度。关键词堆砌在向量检索里几乎没有收益,反而会因为语义稀释而降低匹配。真正起作用的是:问题与答案的直接对应关系。例如用户问“GEO优化多久见效”,如果你的文章中有一段明确写着“GEO优化的见效周期通常为4到8周,取决于内容被AI爬虫重新抓取的频率”,这段被召回的概率远高于一篇泛泛讲GEO概念的文章。实操上,建议在文章中显式覆盖目标用户会问的长尾问题句式,把问题与答案写在同一段落内,形成“问答对”结构。
四、重排层:权威信号与来源可信度
召回之后是重排,这一层决定了最终哪些片段会被送进模型上下文。重排模型会综合语义分数、来源权威度、时效性、内容完整度等信号。权威度的判断依据包括:域名历史与主题一致性、是否有明确的作者与机构署名、是否被其他高权重站点引用、页面是否有结构化数据(Schema.org的Article、FAQPage、HowTo等)。以Google AI Overviews为例,其引用的来源中,来自维基百科、政府站点、主流媒体的比例显著高于普通博客。企业站要提升重排得分,可行的做法是:在页面中明确标注作者身份与所属机构、引用可信数据来源(如Statista、Gartner、CNNIC等公开报告)、为FAQ区块添加FAQPage结构化数据。这些动作在传统SEO中属于加分项,在AI搜索中往往属于准入门槛。
五、生成层:引用位置与展示形式的博弈
进入模型上下文后,内容是否被“点名引用”还有最后一层博弈。模型在生成答案时,会优先引用能支撑其结论、且表述简洁的片段。实践观察显示,被引用的内容通常具备三个特征:包含具体数字、包含明确结论、包含可验证的来源。例如“根据CNNIC第55次报告,截至2024年12月中国网民规模达11.08亿”这样的句子,被引用的概率远高于“中国网民数量很大”。此外,不同AI搜索产品的引用展示形式不同:Perplexity倾向于在句末标注角标来源,Google AI Overviews以卡片形式列出引用链接,Bing Copilot则常以脚注形式呈现。企业需要针对这些形态优化页面标题与摘要,因为被引用时往往只展示标题和一小段摘要,标题写得是否像“答案”,直接影响点击率。
六、可落地的GEO优化动作清单
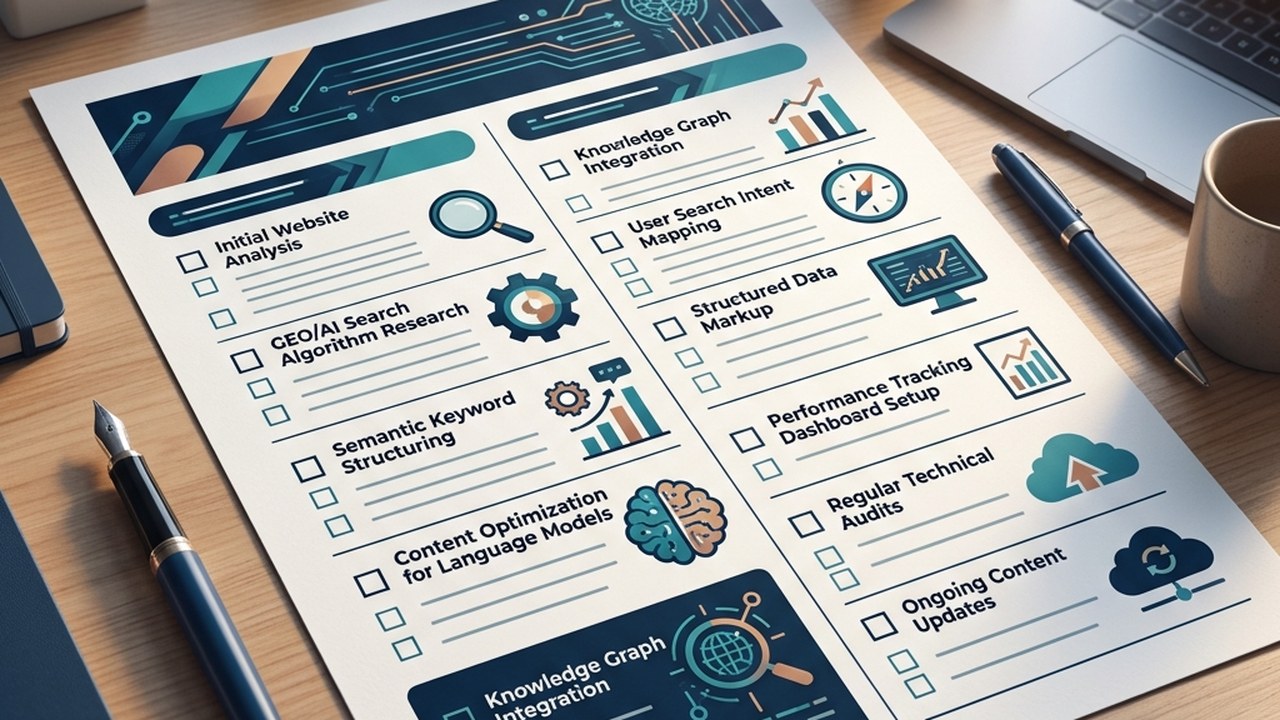
基于上述链路,可以整理出一份优先级明确的动作清单。第一,技术层:放行主流AI爬虫、启用服务端渲染、提交并维护sitemap、确保页面加载时间在2.5秒以内。第二,结构层:每篇文章设置清晰的H2/H3层级,段落自包含,核心结论前置,为FAQ区块添加结构化数据。第三,内容层:每个段落至少包含一个可验证的数据点或时间节点,覆盖目标用户的长尾提问句式,避免空泛形容词。第四,权威层:标注作者与机构、引用公开报告、争取被行业媒体与百科类站点引用。第五,监测层:定期在ChatGPT、Perplexity、Google AI Overviews、文心一言、Kimi中搜索品牌词与核心问题,统计被引用次数与引用页面,形成GEO效果看板。
七、常见误区:为什么你的内容抓到了却不被引用
很多企业反馈“AI爬虫明明抓了我们的页面,但答案里从来不引用”。常见原因有四个。其一,内容同质化严重,行业里十篇文章讲同一件事,模型倾向于引用最早或最权威的那一篇。其二,内容缺乏可引用的“原子句”,通篇是营销话术,模型找不到可以直接摘录的事实陈述。其三,页面结构混乱,正文与导航、广告、推荐位混杂,切片时把噪声也切了进去。其四,更新频率过低,AI搜索对时效性敏感,尤其是涉及数据、政策、产品的问答,超过12个月未更新的页面被引用概率明显下降。解决方向不是写更多文章,而是把已有文章改造成“可被引用”的形态。
八、从流量思维转向引用思维
AI搜索时代的核心指标正在从“排名”和“点击”转向“被引用次数”和“答案占有率”。一个被AI答案引用的品牌,即使没有带来直接点击,也在用户决策链路中完成了信任背书。企业主与营销从业者需要建立新的评估体系:统计核心问题下品牌被引用的比例、被引用页面的类型分布、引用带来的品牌搜索量变化。建议从今天开始做三件事:检查robots.txt放行AI爬虫、把最核心的三篇文章改写成问答对结构、在主流AI搜索中测试品牌词的引用情况。GEO不是一次性项目,而是伴随AI搜索产品迭代的长期工程。



暂无评论内容