

结论先行:GEO(生成式引擎优化)的成败,八成取决于你的内容能否被大模型的RAG(Retrieval-Augmented Generation,检索增强生成)管道顺利召回并被判定为可引用来源。传统SEO争夺的是搜索结果页的排名位次,而GEO争夺的是模型回答里那两三句引用文字和脚注链接。理解RAG的分块、向量召回、重排序、生成归因这四个环节,才能把优化动作落到真正影响输出的地方。本文按RAG的实际运行链路,逐段拆解对GEO策略的影响,并给出可直接执行的优化清单。
RAG到底怎么运转:三段式流程决定了内容的命运
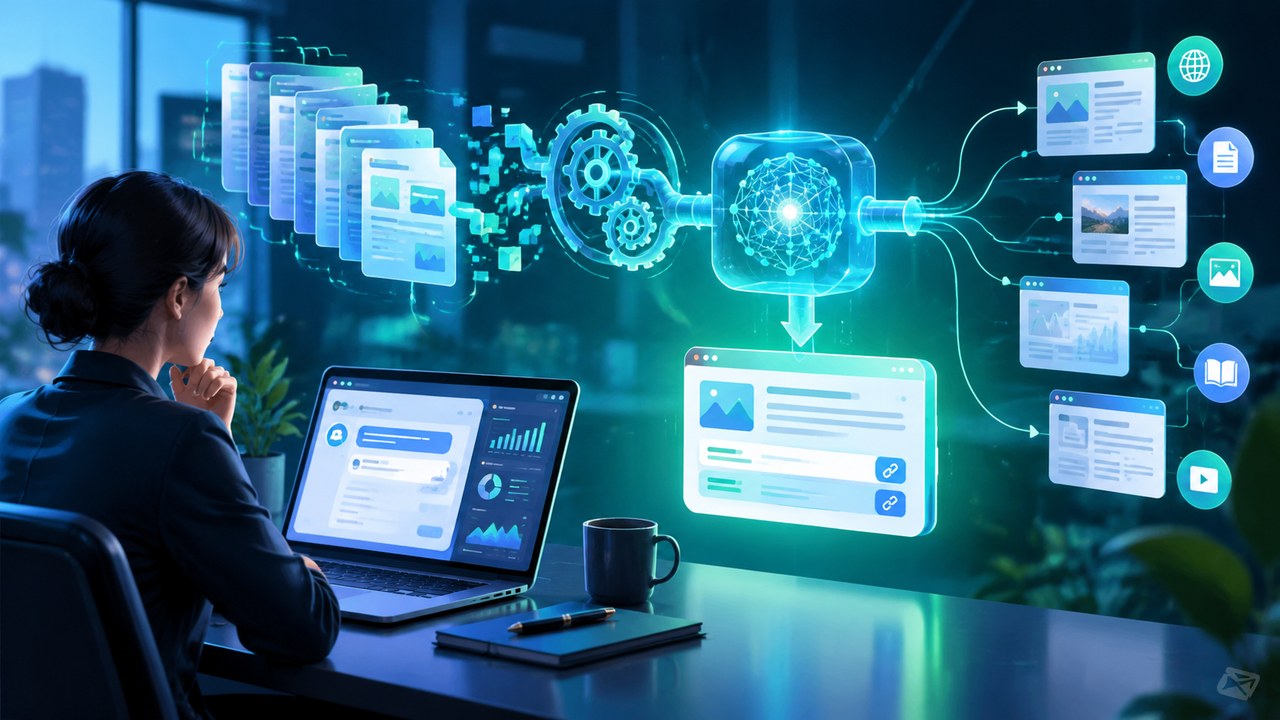
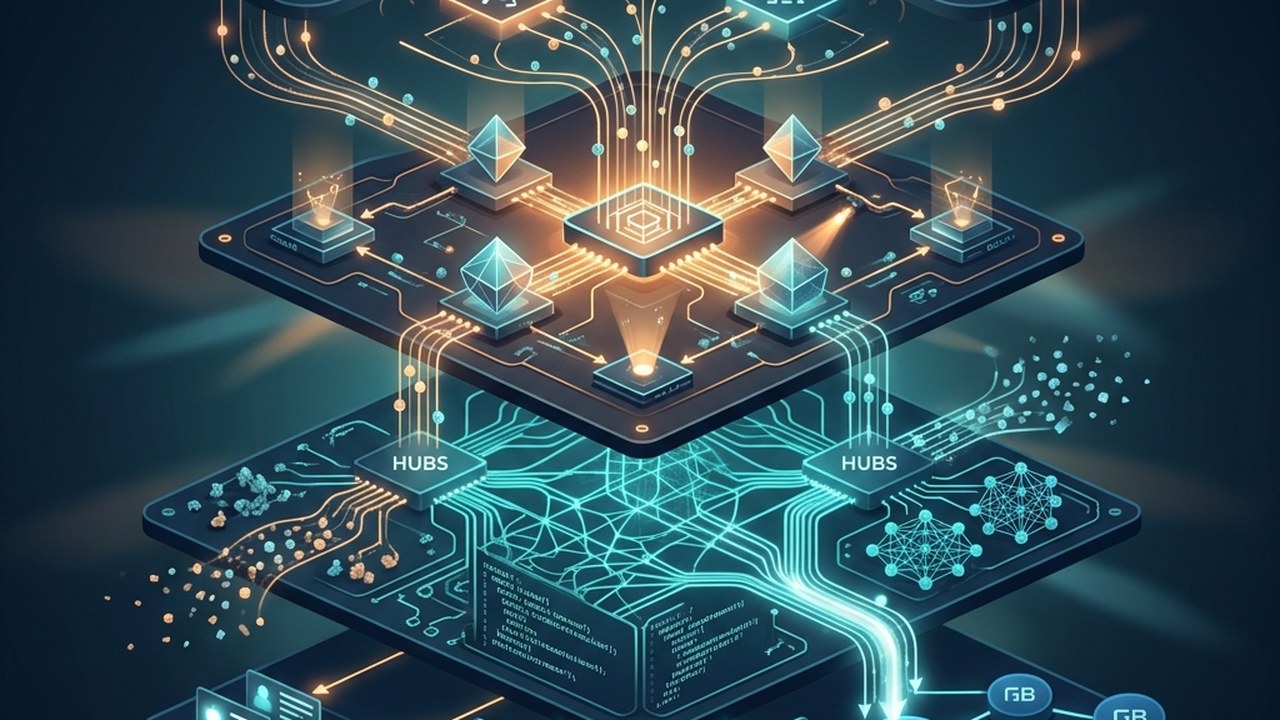
RAG最早由Meta AI研究团队在2020年的论文中提出,核心思路是让大模型在生成答案前先检索外部知识。目前主流实现大致分三段:索引阶段把文档切分成chunk(分块)、用embedding模型转成向量存进向量库;检索阶段把用户问题向量化,通过余弦相似度或混合检索(BM25+向量)召回Top-K片段;生成阶段把召回片段拼进上下文窗口,由模型组织语言输出,并附带引用来源。
这三个阶段里,任何一段出问题,你的内容都不会出现在最终答案中。2024年以来,Perplexity、微软Bing Copilot、Google AI Overviews、百度AI搜索、豆包、Kimi、DeepSeek等产品普遍采用类似架构,差别主要在分块粒度、召回数量和重排序模型。对企业来说,这意味着优化对象从「网页」变成了「可被检索的语义片段」,颗粒度从整页缩小到300到500字的知识块。
分块策略:为什么你的长文被切碎后就失去了竞争力
索引阶段的第一步是分块。常见做法是按固定token数切分,比如512 token一块,块与块之间留10%到20%重叠,避免语义断裂。也有按标题层级、段落边界做语义分块的做法。这直接带来一个GEO结论:一段话如果脱离上下文就说不清楚,它被召回后也很难被模型采用。
实操上要注意三点。其一,每个小节尽量自包含,把主体、结论、数据写在同一段里,避免「如上所述」「该产品」这类依赖前文的指代。其二,小标题要写成能独立回答问题的短句,比如「GEO优化需要多少预算」比「预算问题」更容易匹配用户提问。其三,核心数据尽量前置,因为重排序模型和生成模型都更偏好信息密度高的片段。经验上,把关键结论放在段首第一句,被引用的概率明显高于放在段尾。
向量召回与关键词召回:两套逻辑都要满足
检索阶段通常不是单一向量检索。生产环境里更常见的是混合检索:向量召回负责语义相近,BM25负责精确词匹配。以Elasticsearch、Milvus、Qdrant、Pinecone等常见组件为例,多数系统会先各召回50到100条,再融合排序。
这对GEO的含义是:你不能只做「同义改写」,也不能只堆关键词。品牌名、产品型号、行业术语这类精确词要写全写准,方便BM25命中;同时要用用户真实提问的口语表达覆盖语义空间,比如「AI搜索怎么优化」「GEO和SEO区别」这类长尾问句。建议每篇内容围绕一个主问题,配3到5个变体问句,放在小标题或FAQ区块里,让不同措辞的提问都能命中同一页面。
重排序与权威性打分:模型凭什么选你而不是别人
召回之后是重排序(rerank)。这一步常用交叉编码器模型,把「问题+候选片段」一起打分,精度比单纯向量相似度高得多。同时,不少AI搜索产品会叠加来源权威性权重:域名可信度、内容时效、作者与机构信息、外部引用数量。
所以GEO不只是写好文字,还要经营「被信任的信号」。具体动作包括:页面标注清晰的作者与更新时间,2025年之后的内容在时效上明显占优;引用可核查的数据来源,比如国家统计局、艾瑞咨询、Gartner、IDC等公开报告;在行业媒体、知乎、公众号、垂直社区形成多源提及。当同一事实在多个独立来源出现时,模型更容易把它当作稳定知识采纳。这也是为什么单纯在自己官网发文章,效果往往不如「官网+第三方媒体+问答平台」的组合分发。
引用归因:AI回答里的脚注是如何产生的
生成阶段,模型会把召回片段转写成自然语言,并尽量标注来源。不同产品的归因方式不同:Perplexity习惯给每条陈述配编号脚注,Google AI Overviews倾向聚合多个站点,国内产品有的只在末尾列参考链接。能否被标为来源,取决于片段与最终答案的语义贴合度,以及该片段在上下文中的位置。
优化思路是让内容「容易被摘录」。多用定义式句子,比如「GEO是指……」,多用结构化列表和步骤,多给出可独立成句的结论。避免大段抒情和铺垫,因为模型摘录时只取信息密度最高的部分。实测中,带明确数字、时间、机构名的句子被引用的概率,通常高于泛泛而谈的表述。
面向RAG的GEO执行清单:从内容到技术
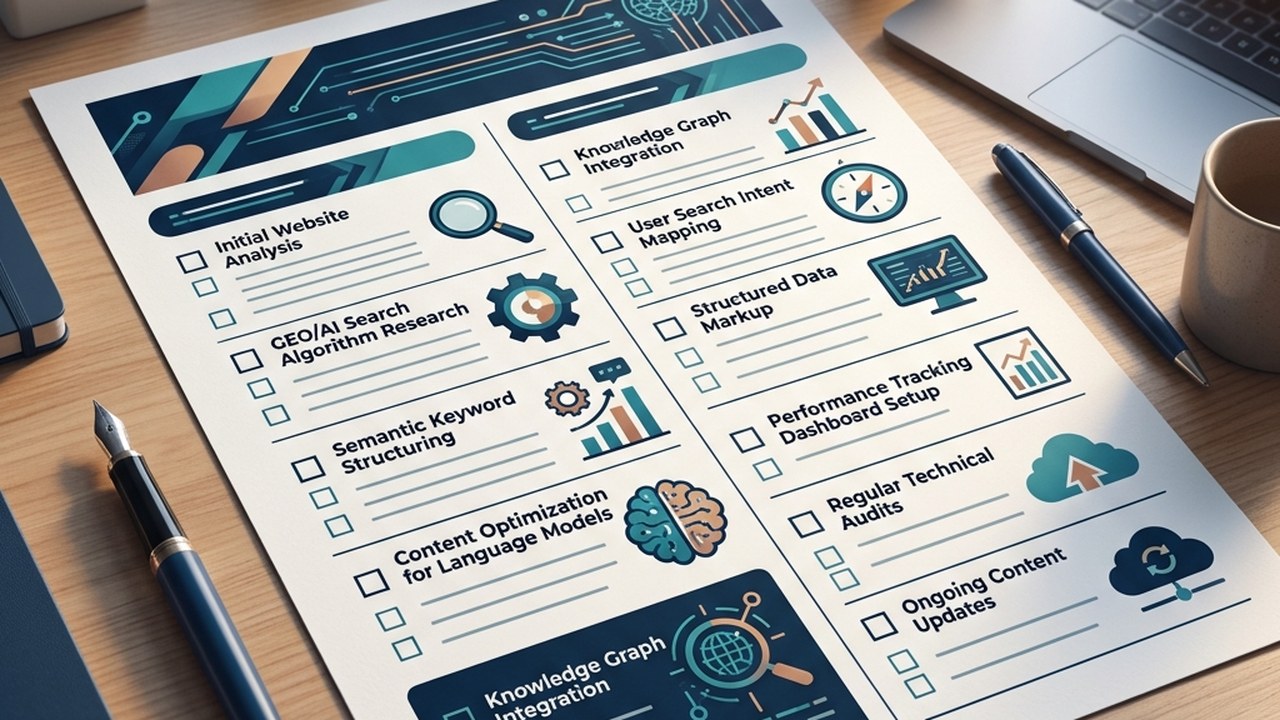
内容层:每篇锁定一个核心问题,开篇给结论;小节自包含;关键数据前置;覆盖3到5个问句变体;保持季度级更新频率。技术层:确保页面可被抓取,不要用JS延迟渲染正文;部署Schema.org结构化数据,重点用Article、FAQPage、HowTo、Organization等类型;提供清晰的sitemap和更新日志;控制页面加载速度,移动端首屏尽量在2.5秒内完成。
分发层:官网做权威源,第三方做背书源。行业媒体投稿、知乎专业回答、公众号深度文、B站或视频号讲解,都能增加被不同检索源抓取的机会。监测层:定期在主流AI搜索产品里测试目标问句,记录是否被引用、引用的是哪一段、脚注指向哪个域名。可以建一个简单的表格,按周记录,观察调整后的变化。
常见误区与效果衡量:别用SEO老指标套GEO
第一个误区是只看排名。AI搜索没有传统意义的第几位,只有「被引用」和「没被引用」。第二个误区是堆量。RAG看重片段质量,一百篇浅文不如十篇结构化深度文。第三个误区是忽视时效,2023年的数据在2025年的问答里被引用概率会下降。
衡量指标建议关注四个:目标问句的引用率、引用片段的准确度、脚注带来的品牌搜索量变化、AI渠道的转化咨询量。工具上,可以用SEMrush、Ahrefs的AI可见度模块,也可以手动在Perplexity、Kimi、豆包、DeepSeek中做对照测试。周期上,内容调整通常需要2到6周才能在检索结果里体现,别指望一周见效。
把RAG当成内容架构的约束条件
与其把RAG当成黑盒,不如把它当成写作规范:为检索而写,为摘录而写,为引用而写。当你的每一段都能独立回答一个问题,每一个结论都有可核查来源,每一次更新都有清晰时间戳,被大模型召回和引用的概率就会系统性提升。GEO不是一次性的技巧,而是把内容体系改造成对机器友好的知识库,这件事越早启动,复利越明显。



暂无评论内容